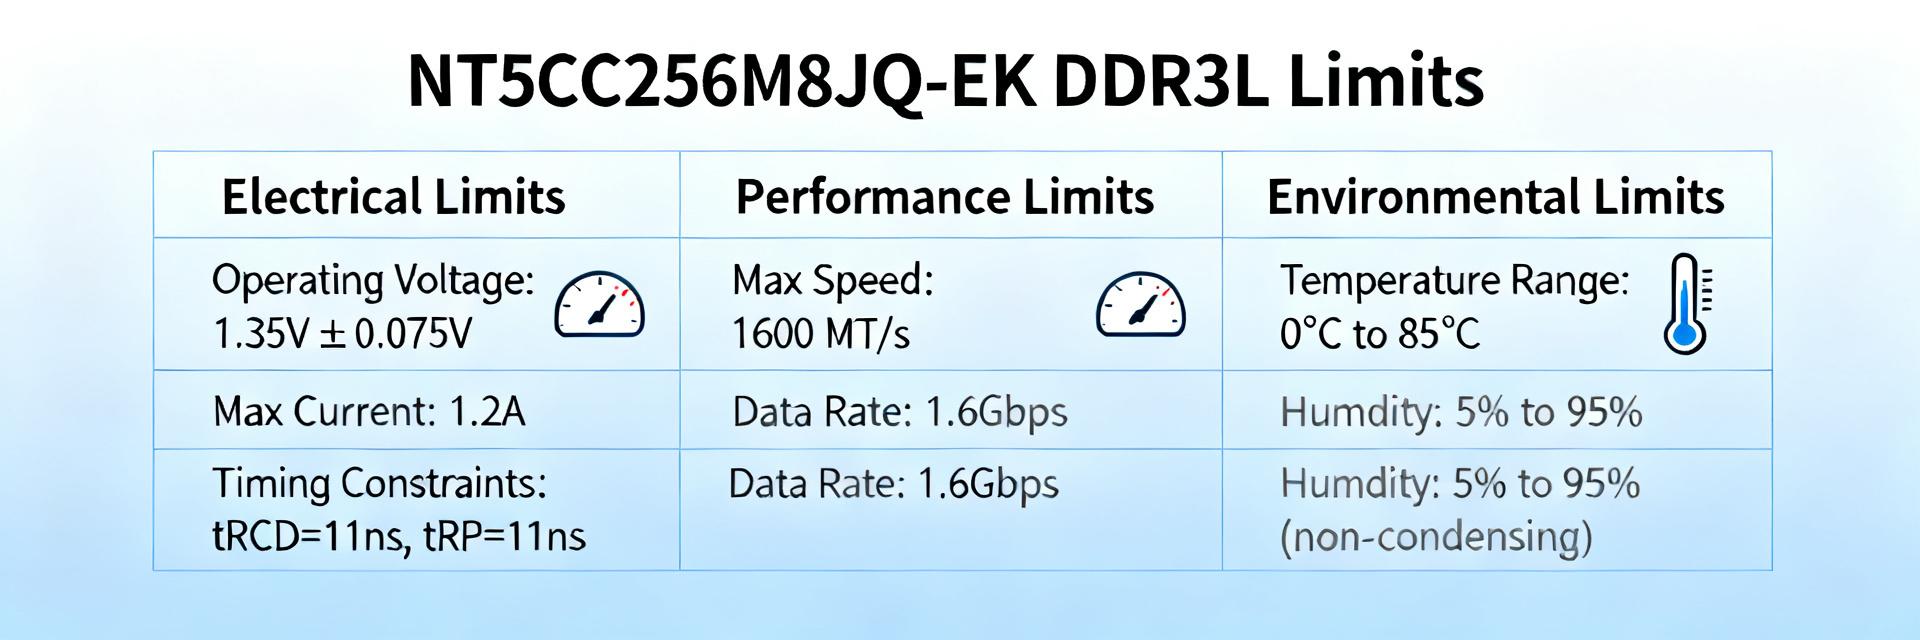
DDR3‑1866 的理论单芯片峰值带宽在纸面上十分直观:1866 MT/s 约等于单个 x8 设备的 1,866 MB/s。本文将这些数据手册中的数值转化为实际可测量的性能限制,用于NT5CC256M8JQ-EK,涵盖吞吐量、延迟、功耗/散热以及信号完整性等方面的边界。工程师将找到一份优先级明确的测试矩阵和调优检查清单,旨在将数据手册中的各项指标与实际系统行为相对应,并识别出导致持续性能下降的最常见瓶颈。 目标与范围:量化预期的持续 MB/s 和延迟范围,识别导致性能偏离峰值的控制器与主板相关因素,并提供切实可行的实验与测量方法,以诊断并提升实际应用中的性能。关键词自然包含NT5CC256M8JQ-EK、DDR3L SDRAM 以及贯穿整个分析过程的性能表现。 1 — 部件快照:架构与关键规格(背景) 1.1 关键电气、物理及速度规格(1–2条内容要点) 测试前需提取的核心公开参数:密度为2Gb,按256M×8组织;速度等级DDR3‑1866;标称VCC为1.35 V(DDR3L);采用TFBGA‑78封装;工作温度范围为标准商用级。内部采用八个Bank及8n预取架构;典型地址/命令引脚数与Bank组织均符合JEDEC DDR3规范。在布局与组装前,请对照物料清单及电路板机械文件核实封装与焊盘图案。 1.2 JEDEC合规性及占位影响 符合JEDEC DDR3/L标准意味着采用标准的时序设置、训练序列和控制器预期;符合JEDEC标准的控制器应能处理初始训练,但电路板布局和扇出设计同样重要。TFBGA-78封装的BGA扇出需要仔细进行焊球映射转换,并确保DQ走线匹配;常见的PCB检查包括推荐的焊盘图形、阻焊开窗以及在关键DQ通道上避免过孔焊盘。组装前,请确认封装、焊球映射及推荐的焊盘图形与物料清单和PCB制造数据一致。 NT5CC256M8JQ-EK 256Mx8 DDR3L-1866 TFBGA-78 VCC(1.35V) GND / VSS CK_t / CK_c A[14:0] / BA[2:0] DQ[7:0] DQS / DQS# DM / ODT / CS# 2 — 理论带宽与实际吞吐量(数据分析) 2.1 理论峰值带宽与有效带宽的计算 计算:1866 MT/s × 8 DQ位 = 每个设备14,928 Mbps → 除以8转换为字节 ≈ 每个x8芯片1,866 MB/s。公式读者可直接使用:峰值MB/s = (MT/s × DQ宽度) / 8。当多个芯片交错或位于不同Rank时,在理想条件下带宽会线性叠加,但实际系统由于共享总线和控制器限制,往往难以达到理论峰值之和。 2.2 实际吞吐量的限制及常见吞吐量损耗因素 在实际应用中,影响吞吐量的主要因素包括控制器开销、命令/周转惩罚、银行冲突、非理想访问模式(随机与顺序)以及系统仲裁。为进行量化分析,需采集持续顺序MB/s、随机IOPS、读写周转时间,并计算实测值与峰值的效率比。根据控制器和交错策略的不同,单芯片的实测持续顺序吞吐量通常会显著低于1,866 MB/s;性能分析应明确区分损耗是源于协议开销还是板级/信号完整性相关问题。 3 — 延迟:时序参数与实际影响(数据分析/方法) 3.1 关键时序参数、换算及示例 关键时序:tCL(CAS)、tRCD、tRP、tRAS。在DDR3‑1866下,数据速率时钟为933 MHz(半速率UI),一个周期约为1.072 ns。换算公式:time_ns = cycles × (1 / (MT/s / 2))。以下示例换算结果既以周期表示,也以纳秒表示,非常适用于测试报告中。 时序周期约纳秒 CL1111约11.8 ns tRCD1111约11.8 ns 在测试结果中同时以周期和纳秒两种单位报告延迟;周期对于控制器调优至关重要,而纳秒则反映了软件和系统因实时性要求所承受的绝对延迟。 3.2 时序、命令速率与交错方式如何影响可观察到的延迟与性能 命令速率(1T 与 2T)会改变命令总线的时序,并可能在许多事务中增加一个时钟延迟;而银行交错通过允许激活与预充电的重叠,从而降低平均延迟。页面命中与未命中对平均延迟的影响很大——单银行热点循环由于频繁的 tRP/tRCD 惩罚,将表现出最差的延迟。实验内容包括:切换 1T/2T、运行单银行锤击模式以及全页顺序模式,以量化每次变化带来的延迟和吞吐量差异。 4 — 功耗、热管理和信号完整性约束(方法与案例考量) 4.1 功耗包络、DVFS/漏电及其对持续性能的影响 供电电压预期为1.35 V;动态功耗随I/O翻转、刷新率及更高的活动因子而增加,而静态漏电流则与温度相关。在施加应力时,使用电流检测电阻或串联式电流表测量电路板的VCC,并记录温度。测试设备应包括电流探头、BGA中心的热敏探头,以及用于记录电压降的系统——导致错误上升的阈值因具体实现而异,因此需通过逐步施加应力来确定电压、电流和温度的临界点,以识别稳定性下降的情况。 4.2 热极限、PCB布局及信号完整性最佳实践 TFBGA‑78的热传导仅限于球形通孔和平面耦合;热点通常出现在芯片中心附近以及高活动的地址/命令缓冲区区域。建议的PCB叠层设计包括用于返回电流的实心电源平面、匹配长度的DQ差分对、飞线式地址/命令布线,以及受控阻抗走线。请检查回流焊曲线并进行信号完整性检查——由信号完整性引起的故障包括训练失败、误码率升高以及眼图模糊;可使用眼图监测仪和误码率压力测试来发现这些问题。 5 — 测试计划与优化检查清单(方法指南+行动建议) 5.1 用于界定极限的最小测试矩阵(基准测试、模式、指标) 有序测试计划:1)上电培训验证;2)基本读写功能检查;3)顺序突发吞吐量;4)随机小块读写(4K/64K);5)单Bank压力测试与锤击测试;6)刷新及长时间压力测试;7)温度扫描。记录MB/s、延迟(ns)、IOPS、错误计数、VCC及温度。提前设定通过/失败阈值(例如,错误率低于0.1%,稳态吞吐量在基准值的X%以内)。 5.2 调优手段与风险矩阵(需调整的内容、预期收益及风险) 调节旋钮:用于延迟与稳定性之间的时序(tCL/tRCD/tRP)、命令速率1T/2T、驱动强度与ODT、Vref与电压裕量、交错与Rank配置,以及低功耗状态设置。请逐步验证各项更改,并从控制器设置到电压裕量逐级上报。每次调整后,务必在目标温度下运行长时间压力测试,以在部署前发现潜在的间歇性故障。 摘要(占文章的10–15%) 理论峰值约为每x8设备在DDR3‑1866下1,866 MB/s;由于控制器开销和系统效应,实测性能会更低。 NT5CC256M8JQ-EK(DDR3L SDRAM)的行为深受时序、命令速率、Bank交错以及板级信号完整性与热管理因素的影响。 按照既定的测试矩阵进行:验证培训效果,测量顺序/随机吞吐量,进行电源与散热压力测试,然后通过仔细的验证来调整时序和电压裕度。 常见问题解答 如何验证NT5CC256M8JQ-EK我的系统是否达到了标称带宽? 在记录MB/s、VCC和温度的同时,运行持续的顺序读写突发。将实测的持续MB/s与理论基准1,866 MB/s进行比较,计算效率比。若效率较低,可使用针对性的单bank模式和交错模式,排查控制器开销、Bank冲突或信号完整性问题。 对于DDR3L SDRAM测试,哪种延迟报告最为有用? 同时报告tCL、tRCD、tRP以及平均观测到的读写延迟的周期数和纳秒值。周期数有助于控制器调优;纳秒值则显示对软件的绝对延迟。此外,还应纳入分布指标(中位数、p95),以揭示因页面未命中或刷新干扰导致的尾部延迟。 哪些检查方法最快能发现影响性能的信号完整性或热问题? 运行内存训练验证、眼图或误码率测试,并在进行多次大容量连续突发时进行短时间的温度扫描。观察是否存在训练失败、误码率上升、错误计数增加,或与温度或电压跌落相关的突发吞吐量下降,从而定位信号完整性或热限制。 命令速率和银行交错如何解决吞吐量瓶颈? 在信号完整性允许的情况下,从2T时序改为1T时序,每个命令事务可节省一个周期。多银行交错则将激活和预充电操作在全部8个内部银行之间重叠执行,从而消除单银行访问循环中常见的空闲等待周期。